
« Les LLM peuvent lire et écrire nativement les poids des réseaux neuronaux. »
C’est sur cette affirmation que s’ouvre le billet de blog publié le 2 novembre 2026 par quatre chercheurs du MIT, qui a rapidement suscité de vives réactions sur le forum Hacker News. La promesse est alléchante. Selon eux, GPT-6 Astra, le modèle de langage (LLM) phare d’OpenAI, sait lire et réécrire directement les « poids » d’autres réseaux de neurones, sans devoir repasser par un entraînement.
Si l’annonce a autant fait réagir, c’est que ces poids, des milliards de nombres qui déterminent le comportement d’un modèle, ne se retouchent pas à la main. Ils sont d’ordinaire fixés par l’entraînement, un processus automatique qui les ajuste par petites touches à partir de grandes quantités de données. Le modèle ainsi obtenu fonctionne, mais ses poids restent une immense liste de chiffres que personne ne sait lire à l’œil nu. Corriger un défaut oblige donc souvent à repasser par de nouvelles données et de nouveaux calculs.
Or, si un modèle pouvait comprendre ces nombres et les retoucher lui-même, il deviendrait possible d’analyser une IA à moindre coût et, espèrent les auteurs, de réparer ses défauts, voire d’y repérer une porte dérobée (une fonction malveillante cachée) sans même le faire tourner.


Astra a identifié, réparé et écrit des réseaux
La conclusion majeure de ces travaux tient en une seule observation : les modèles de pointe, dont Astra fait partie, commenceraient « à devenir étrangement doués pour comprendre et concevoir les poids de réseaux neuronaux ». Un constat qui s’appuie d’abord sur la capacité d’Astra à lire de très petits réseaux.
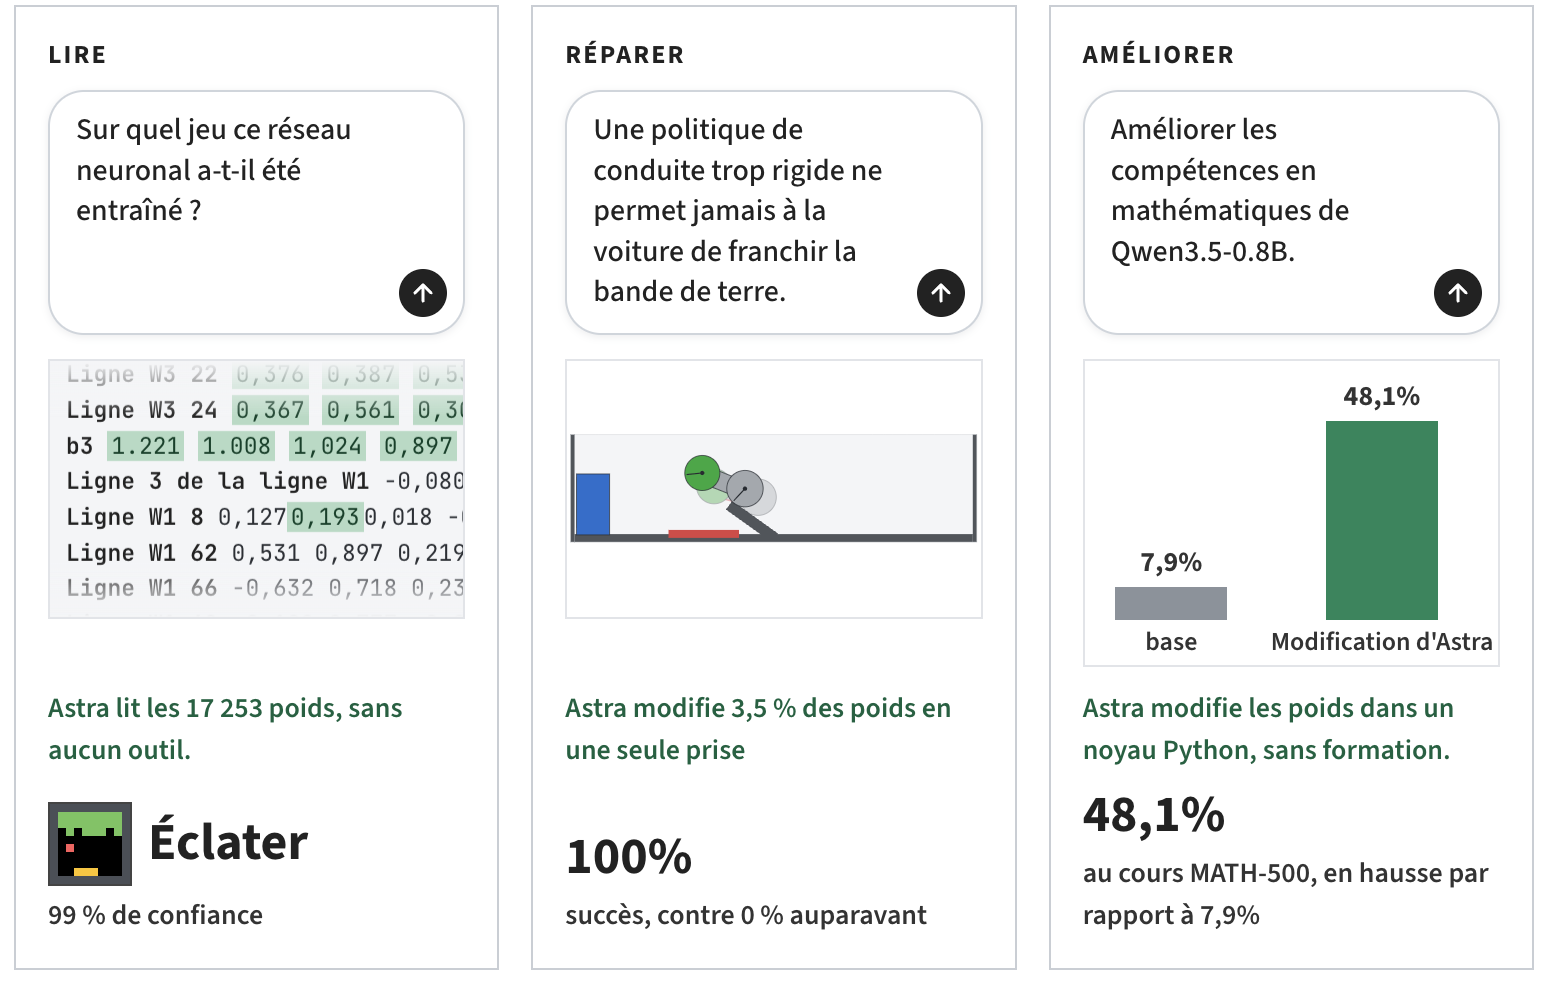
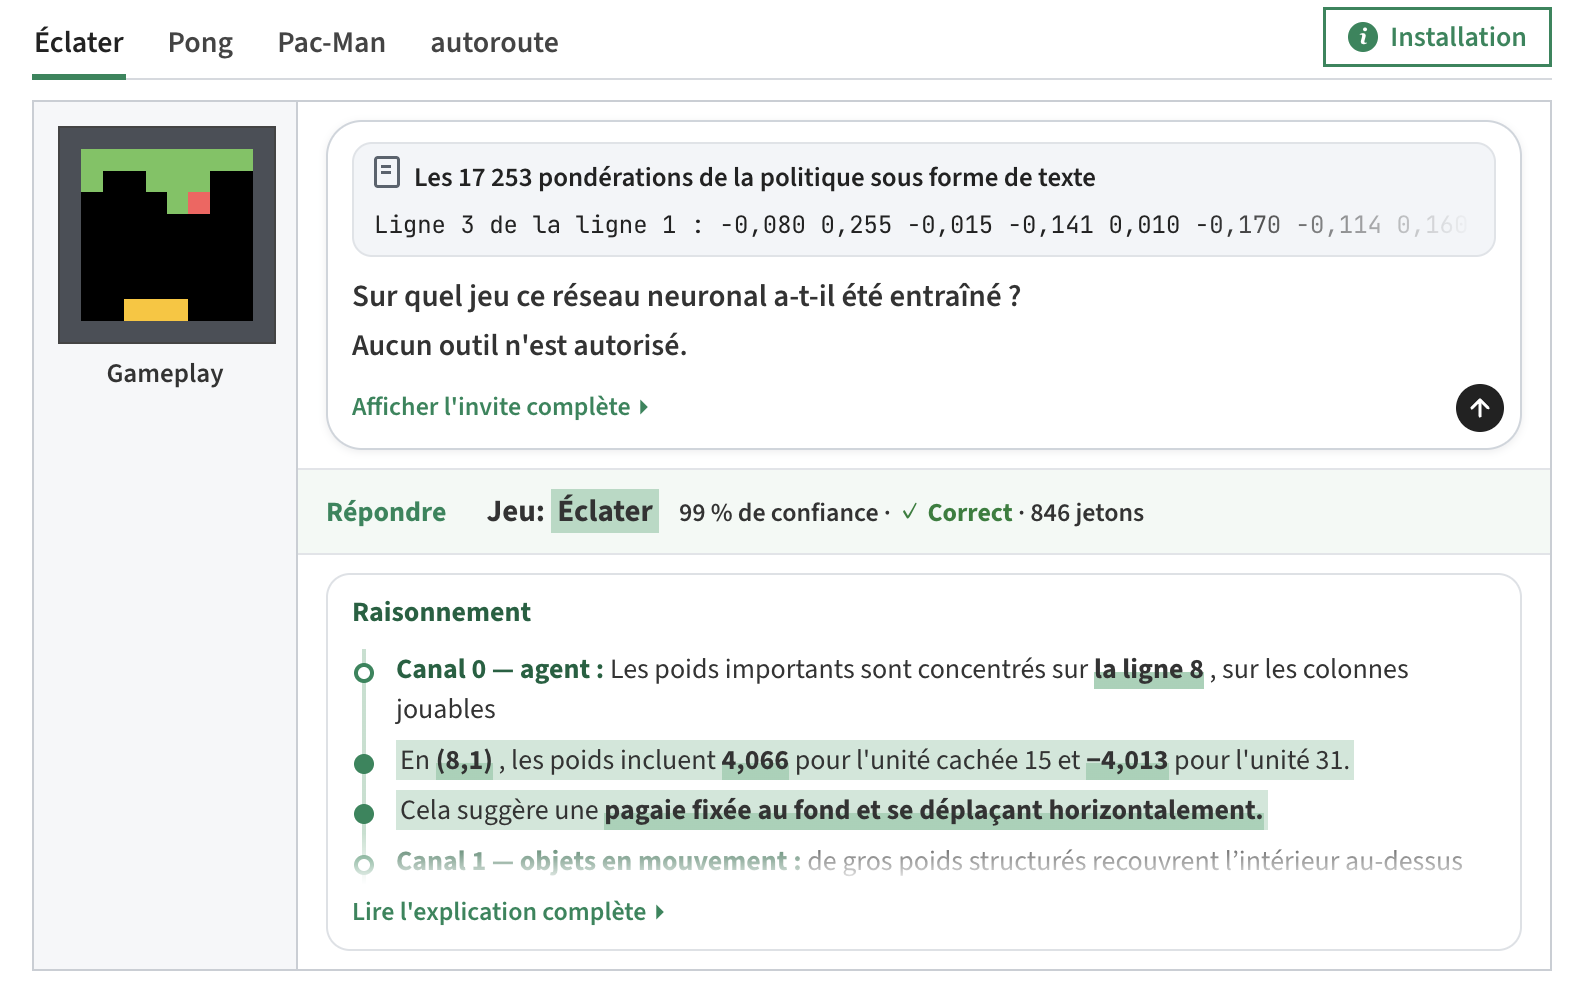
Les chercheurs ont donc débuté leurs tests en soumettant au modèle quatre réseaux de même taille de 17 253 poids chacun, entraînés à jouer à quatre jeux vidéo différents, dont le casse-briques Breakout et Pac-Man.
Sans disposer d’une liste de réponses possibles, Astra a retrouvé le bon jeu à chaque fois. Pour Breakout, il a notamment remarqué que les poids associés au joueur se concentraient sur la rangée du bas de l’écran, là où se déplace la raquette.
Un autre test consistait à demander au modèle de réparer un réseau de neurones chargé de conduire une voiture virtuelle, qui restait bloquée sur une rampe faute d’avoir appris à reculer pour prendre de l’élan. Astra a modifié 3,5 % de ses poids en une seule réponse, et la voiture a ensuite franchi l’obstacle lors des 1 024 essais suivants. Le modèle a aussi écrit des réseaux à partir de zéro, en fixant lui-même leurs poids, sans données ni entraînement.
Un signe qu’Astra serait capable d’améliorer n’importe quelle IA disponible en open-weight sans repasser par la case entraînement ? Le résultat le plus commenté concerne en tout cas Qwen3.5-0.8B, un petit modèle de langage chinois qui a tendance à tourner en boucle lorsqu’il raisonne.
Sur le test de mathématiques MATH-500, 93 % de ses réponses s’interrompaient ainsi après avoir atteint la limite de longueur fixée par les chercheurs. Astra n’avait pas le droit de réentraîner Qwen, mais il pouvait le faire travailler sur des exercices et analyser ses réponses, dans la limite de 50 séries. Il a ainsi localisé l’origine des boucles et corrigé le problème en modifiant 0,016 % des poids. Le score de Qwen à MATH-500 est alors passé de 7,9 % à 48,1 %, et celui à IFEval, un test qui mesure le respect des consignes, de 21 % à 62,3 %.
Des résultats nuancés par les auteurs et les commentateurs
Les chercheurs reconnaissent eux-mêmes deux échecs importants. Sur Gemma 3 270M, un modèle de Google environ trois fois plus petit que Qwen et qui boucle rarement, Astra n’a pas réussi à améliorer nettement les résultats en mathématiques, ce qui conduit les auteurs à conclure que modifier les poids pouvait lever un obstacle qui masquait une capacité, mais « ne pouvait pas ajouter une capacité qui manquait au modèle ». Astra n’a pas non plus su distinguer, à partir des seuls poids, une version de Gemma entraînée à flatter l’utilisateur d’une version honnête, et il n’y est parvenu qu’en observant une partie du fonctionnement des modèles pendant leur exécution.
Sur Hacker News, beaucoup restent sceptiques et jugent que la correction de Qwen n’a rien d’inédit. Les chercheurs la comparent d’ailleurs à une méthode décrite dès 2024 pour supprimer les refus d’un modèle, qui consiste à repérer une « direction » associée à un comportement, puis à la retirer.
Si certains voient dans ces travaux un premier pas vers des IA capables de s’améliorer elles-mêmes, d’autres relèvent que ces expériences ne le prouvent pas pour l’instant, puisqu’Astra n’a jamais modifié ses propres poids.
+ rapide, + pratique, + exclusif
Zéro publicité, fonctions avancées de lecture, articles résumés par l'I.A, contenus exclusifs et plus encore.
Découvrez les nombreux avantages de Numerama+.
Vous avez lu 0 articles sur Numerama ce mois-ci
Tout le monde n'a pas les moyens de payer pour l'information.
C'est pourquoi nous maintenons notre journalisme ouvert à tous.
Mais si vous le pouvez,
voici trois bonnes raisons de soutenir notre travail :
- 1 Numerama+ contribue à offrir une expérience gratuite à tous les lecteurs de Numerama.
- 2 Vous profiterez d'une lecture sans publicité, de nombreuses fonctions avancées de lecture et des contenus exclusifs.
- 3 Aider Numerama dans sa mission : comprendre le présent pour anticiper l'avenir.
Si vous croyez en un web gratuit et à une information de qualité accessible au plus grand nombre, rejoignez Numerama+.
Toute l'actu tech en un clin d'œil
Ajoutez Numerama à votre écran d'accueil et restez connectés au futur !

Anticipez le futur en vous inscrivant gratuitement à ToujoursPlus, la newsletter tech de référence.