
Après Claude, OpenAI annonce à son tour que les textes générés par ChatGPT pourront bientôt être repérés grâce à une marque invisible. Dans un billet de blog publié le 5 octobre 2026, le laboratoire IA explique que cette signature, intégrée au texte, permettra à son détecteur de rechercher une trace de l’intervention de ses modèles.
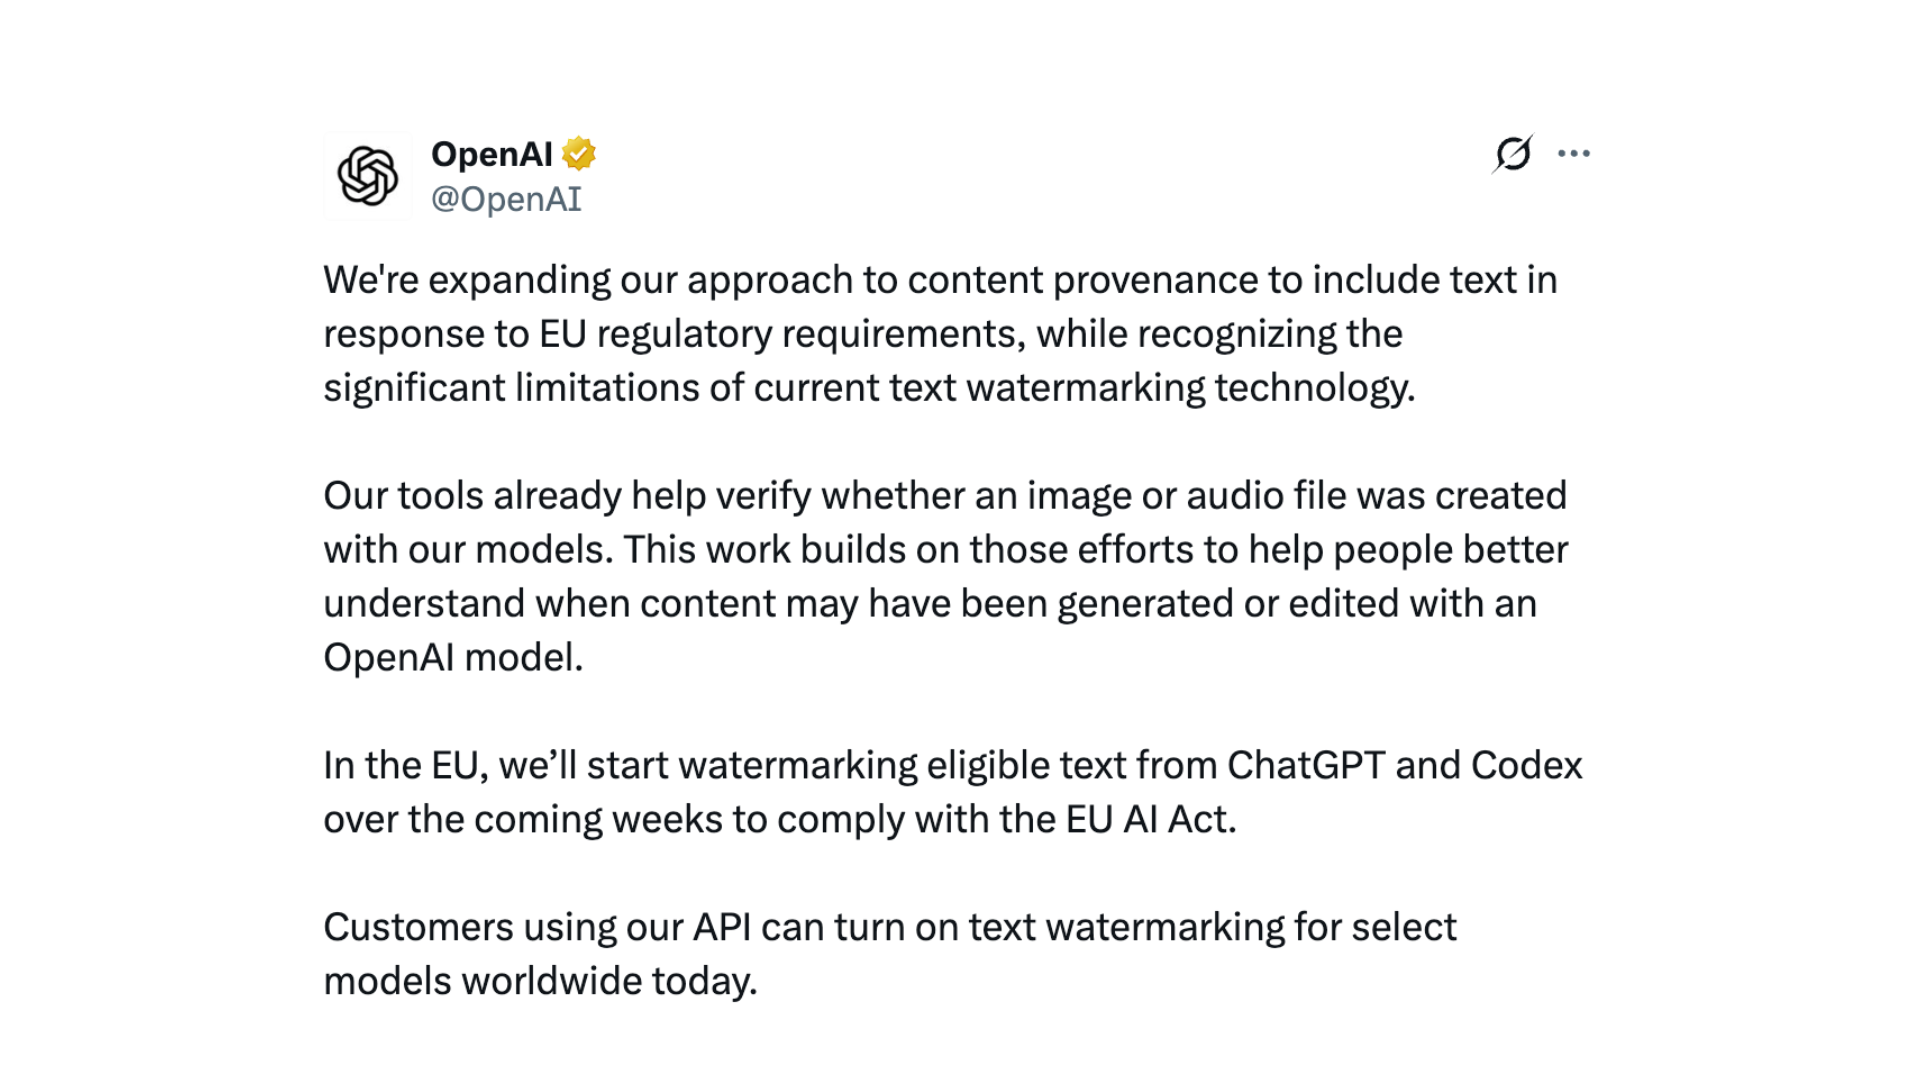
Le dispositif sera progressivement déployé dans ChatGPT et Codex au cours des prochaines semaines dans l’Union européenne, y compris en France. Il concernera les réponses textuelles « éligibles » pour les offres gratuites comme payantes. OpenAI ne détaille toutefois pas les critères d’éligibilité.
Comment ChatGPT va-t-il marquer ses textes ?
Concrètement, le filigrane ne sera ni un logo ni une mention « généré par ChatGPT ». Il reposera sur la manière dont le modèle choisit ses mots.
Quand ChatGPT rédige une réponse, il avance par petits fragments, appelés « tokens » : des mots ou des morceaux de mots. À chaque étape, plusieurs suites sont possibles. Après « La matinée était », il pourrait par exemple écrire « calme », « froide » ou « ensoleillée », selon le contexte.
Le dispositif d’OpenAI, baptisé textGrain, intervient au moment de ce choix. À l’aide d’une clé secrète, il favorise certaines possibilités parmi celles que le modèle envisage. Ces préférences changent selon ce qui vient d’être écrit. Au fil de la réponse, elles laissent une signature invisible dans la façon de choisir les mots.
Le détecteur utilise ensuite la même clé pour rechercher cette signature. Il examine l’ensemble du passage pour vérifier si les choix de mots suivent suffisamment les préférences du dispositif. Pour cela, il lui suffit d’analyser le texte avec la clé secrète, sans accéder à l’échange avec ChatGPT qui l’a produit. Un simple copier-coller conserve cette signature puisqu’il conserve les mots. Une réécriture ou une traduction peut, en revanche, l’affaiblir et la rendre moins détectable. C’est exactement de cette manière que fonctionne Pangram, l’outil tiers qui a beaucoup fait parler en septembre avec l’affaire Thélyson Orélien. Le modèle est entraîné à partir de textes IA et peut reconnaître certains signes prédictifs.
Pourquoi ce déploiement concerne-t-il seulement l’Union européenne ?
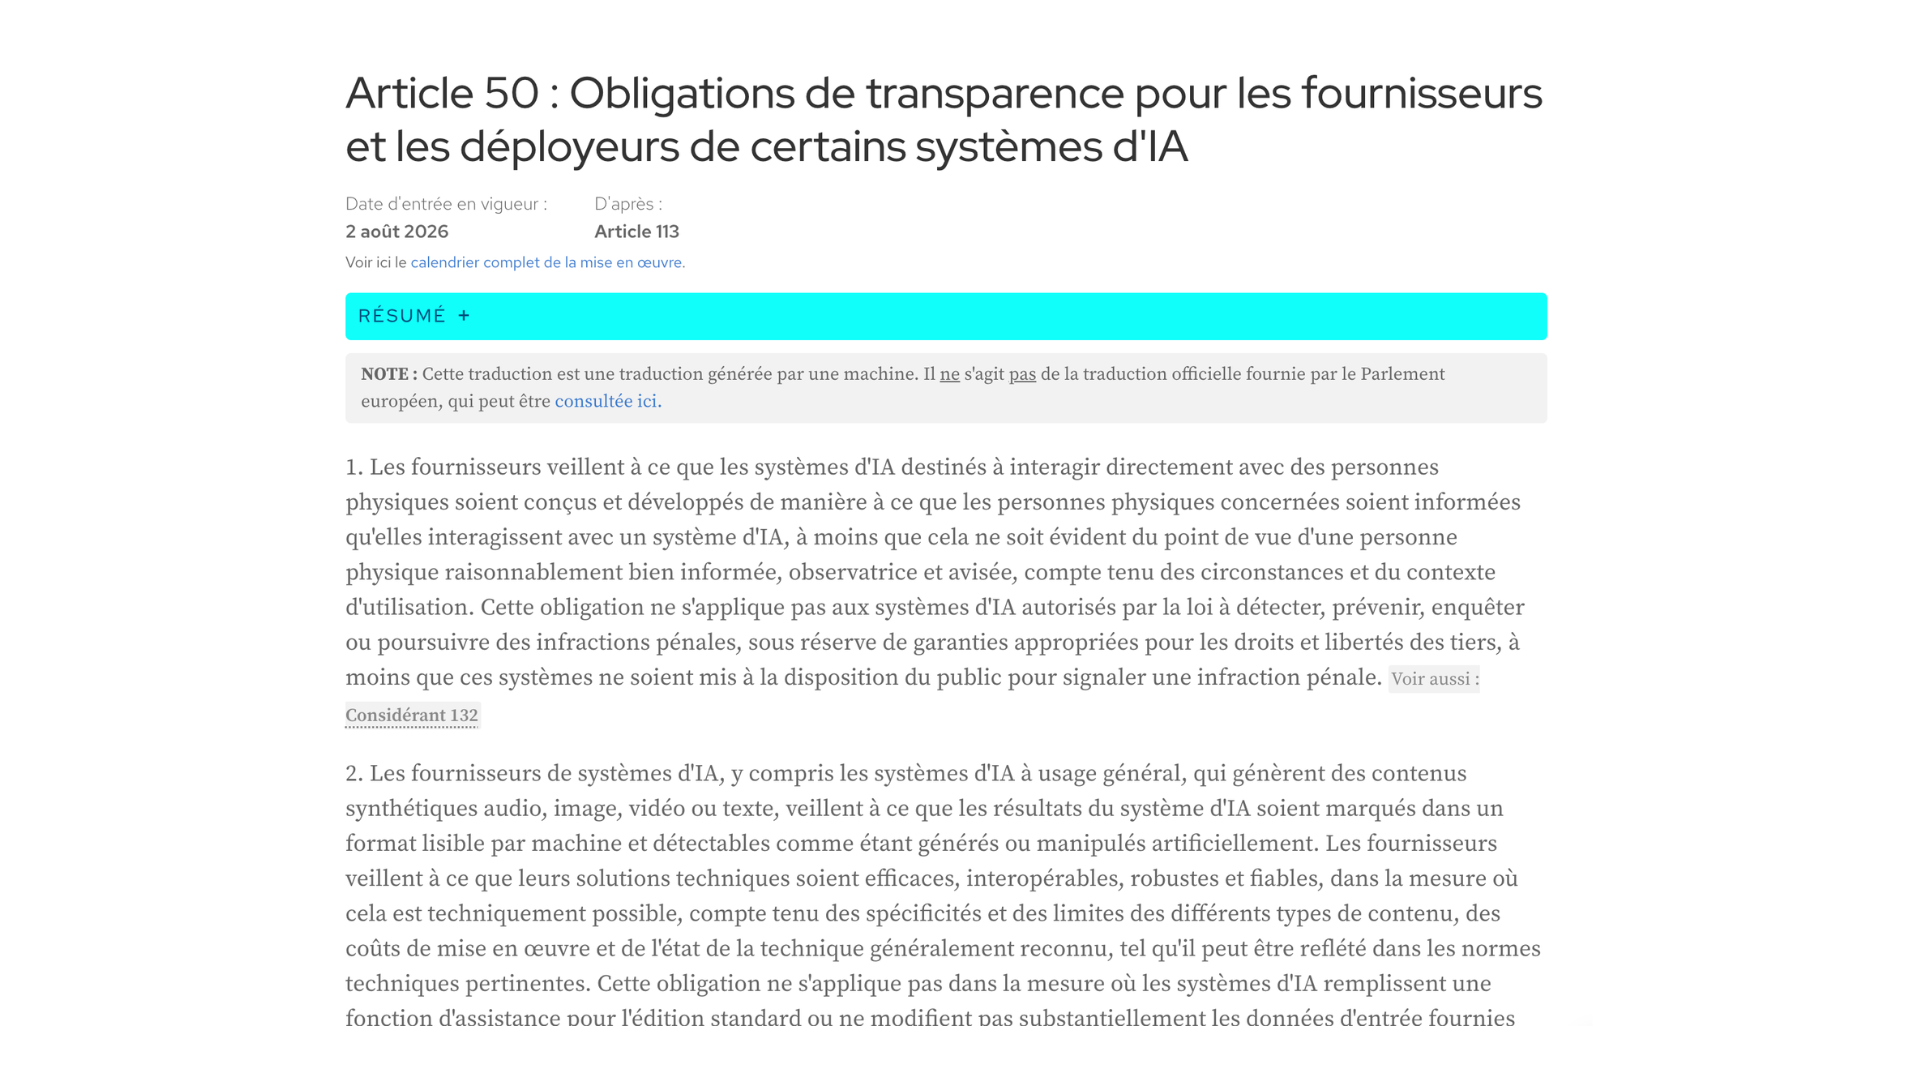
Ce déploiement répond à une obligation européenne. L’article 50 de l’AI Act demande aux entreprises concernées de marquer les contenus générés ou modifiés par leur IA pour qu’un outil informatique puisse les reconnaître. Selon la Commission européenne, cette règle s’applique depuis le 2 août 2026.
Elle prévoit toutefois des exceptions lorsque l’IA aide simplement à corriger un texte ou apporte des changements qui n’en modifient pas vraiment le contenu. Corriger quelques fautes d’orthographe n’impose donc pas nécessairement d’ajouter un filigrane.
Comme nous l’expliquions dans notre article sur Claude, Anthropic a quant à lui choisi de marquer les textes de ses modèles compatibles dans le monde entier. OpenAI, lui, limite pour l’instant le marquage automatique à l’Union européenne. Depuis le 5 octobre, les clients de son API peuvent aussi l’activer pour certains modèles, partout dans le monde. Il y reste toutefois désactivé par défaut.
Attention : un filigrane ne constitue pas une preuve
Le détecteur peut se tromper dans les deux sens : signaler une marque dans un texte qui n’en contient pas, ou passer à côté d’une marque présente.
Même lorsqu’un texte contient un filigrane, le détecteur ne le retrouve pas toujours. Dans un test d’OpenAI sur des textes de psychologie de 200 tokens, il manque la marque dans environ un cas sur cinq. Sur des textes deux fois plus longs, il ne la manque plus que dans un cas sur vingt. Un passage court laisse donc moins de chances de repérer l’intervention de l’IA.
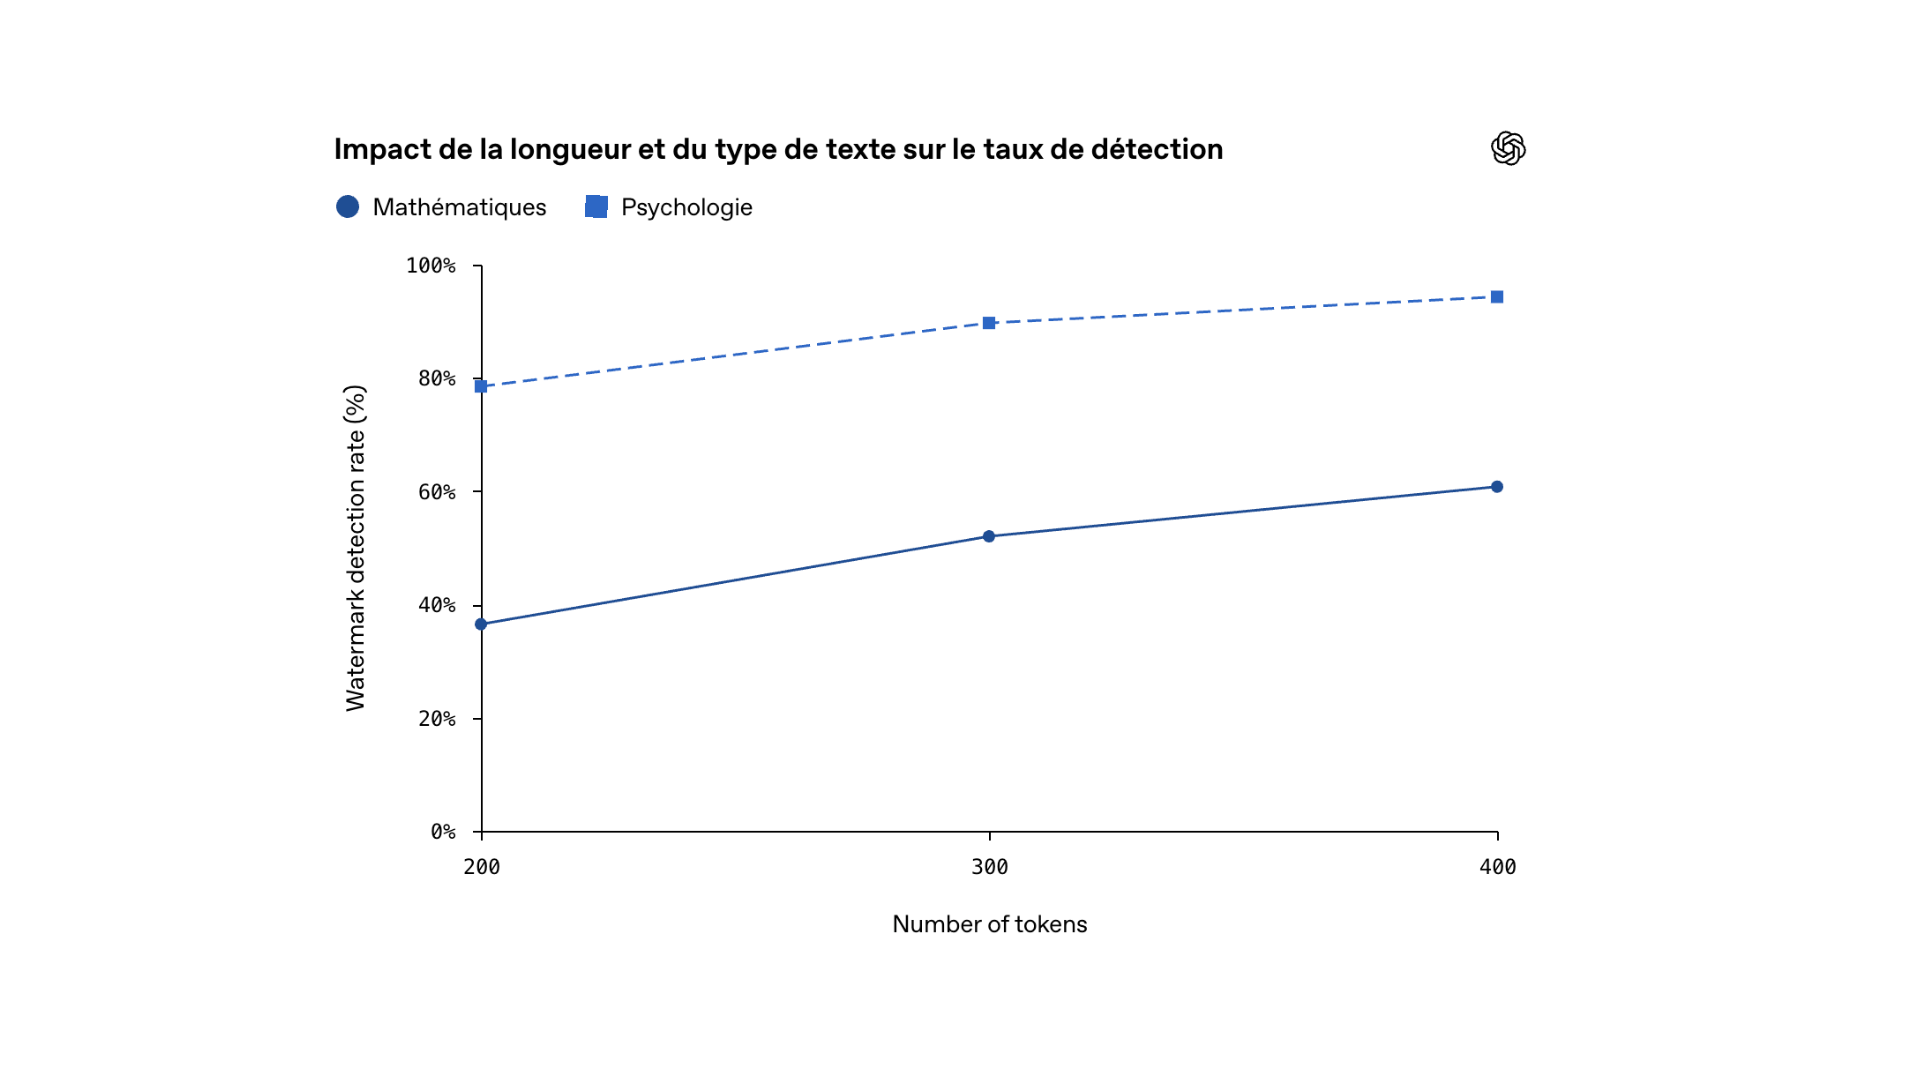
Le sujet compte aussi. En mathématiques, par exemple, le modèle a moins de liberté pour choisir ses mots, ce qui rend la signature plus difficile à détecter.
Modifier le texte peut également brouiller cette trace. Dans un autre test sur des passages en anglais de 400 tokens, remplacer 10 % des mots par des synonymes fait passer le taux de détection d’environ 92 % à 66 %. Avec 25 % de mots remplacés, il tombe à 17 %.
À cause de ces limites, OpenAI réserve pour l’instant son détecteur à des chercheurs et organismes spécialisés qu’il aura approuvés. Vous ne pourrez donc pas encore y soumettre un texte pour vérifier s’il contient une marque de ChatGPT.
+ rapide, + pratique, + exclusif
Zéro publicité, fonctions avancées de lecture, articles résumés par l'I.A, contenus exclusifs et plus encore.
Découvrez les nombreux avantages de Numerama+.
Vous avez lu 0 articles sur Numerama ce mois-ci
Tout le monde n'a pas les moyens de payer pour l'information.
C'est pourquoi nous maintenons notre journalisme ouvert à tous.
Mais si vous le pouvez,
voici trois bonnes raisons de soutenir notre travail :
- 1 Numerama+ contribue à offrir une expérience gratuite à tous les lecteurs de Numerama.
- 2 Vous profiterez d'une lecture sans publicité, de nombreuses fonctions avancées de lecture et des contenus exclusifs.
- 3 Aider Numerama dans sa mission : comprendre le présent pour anticiper l'avenir.
Si vous croyez en un web gratuit et à une information de qualité accessible au plus grand nombre, rejoignez Numerama+.
Toute l'actu tech en un clin d'œil
Ajoutez Numerama à votre écran d'accueil et restez connectés au futur !

Tous nos articles sont aussi sur notre profil Google : suivez-nous pour ne rien manquer !